2025年のふりかえり
2025年に自分がやったことをふりかえる記事です。
2024年末に言っていたこと
やりたいことというか、こうありたいという感じです。
(中略)
起きて、朝日を浴びて、身支度を整えて、PCの前に座って、コードを書いたり、詰まったり、質問したり、必要なことをインプットしたりするのを繰り返して、気づいたら2026年もなんとかプログラマとして迎えられた、そんな感じだったらいいなと思っています。
昔からプログラマをやっている人からするとごく当たり前なこのことが、初めて経験する私にとってはおそらく大変かもしれないと想像します。でも、自分を追い込みすぎず、適度な大きさに分解した眼の前の問題に向き合って、一つの小さな過程を乗り越えられたら、自分を褒めてまた次に行く。そんなサイクルを繰り返していけたら120点ですね。
2025年にできたこと
- プログラマとしてのキャリアをスタートさせ、丸一年続けることができた。
- 学習時代には触れていなかった領域に、仕事を通して実務として継続的に触れることができた。
- 地域Rubyや各種イベントに参加した。
- Kaigi on Rails 2025
- AKASHI.rb
「学習時代には触れていなかった領域」については、主に REST な Ruby on Rails によるバックエンド開発を学習してきた自分としては、ここで地味に負荷が発生し続けていたような気がしています。
もちろん、仕事ではプロジェクト遂行に必要な知識を素早くインストールして業務を進めていかないといけないので、これくらいは慣れていかないといけない、という認識はしていたのですが。
小さな受託開発企業で、プロジェクトを横断しながらバタバタとやっていたこともあり、気持ち的な疲れが来るところもありました(その分、幾分か成長できたであろう事実も、きちんと認めていきたいところです)。
あらためて、2024年末に立てた目標について
『起きて、朝日を浴びて、身支度を整えて(…)を繰り返して、気づいたら2026年もなんとかプログラマとして迎え』ることは、できたと思っています。
ただ、『自分を追い込みすぎず(…)一つの小さな過程を乗り越えられたら、自分を褒めてまた次に行く』という点については、あまりできなかったかもしれません。
実力のない、不甲斐ない自分自身を責めてしまう一方で、自分を褒めることはあまりできていなかったなと思います。
このあたりは、来年というか、人生をかけてゆっくりと改善を目指していきたいところですね。
ただ、しんどいときに羅針盤のようにしていた言葉があって、それは『未経験転職からの1年目なんて、生き残れたらそれで100点』(意訳)です。これは「RESTUDY Cafe」というコミュニティで、入社1週間後のタイミングでたまたま雑談させていただいたときに、コミュニティのメンバーの方からいただいた言葉です。
生き抜いたので、100点ですね。この言葉には本当に感謝しています。
2026年について
この流れ的には、 「1年目は生き残れたら100点だけど、2年目以降は生き残る以上の価値創造を……」という話になりそうなのですが、それだとまた自分を追い詰めてしまいそうで、難しいところだと感じています。
なので、現時点ではあまり目標らしい目標は、あえて立てないでおこうかなと思います。もし余裕があれば、AWS 認定試験を取っていけたらな……くらいでしょうか。
2025年も、プログラマ関係の知り合いの皆様には大変お世話になりました。いつも優しい言葉をかけていただき、本当に助けになりました。できるだけ私もお返しができたらと思っていますので、なにかありましたらお声がけいただければと思います(結果的にお話を聞くことしかできないかもしれませんが、それでも何かの力になれば……)。
それでは、2026年もよろしくお願いします。
オライリーで購入した EPUB を Kindle 端末に送る
「ウェブ版Send to Kindle」が便利でした。
オライリーの Web サイトで電子書籍を購入した後、手元にダウンロードした EPUB ファイルをドラッグアンドドロップするだけ。 1分くらいで手元の Kindle Paperwhite でダウンロードして読めるようになりました。
ウェブ版だけでなく、メールや Chrome 拡張機能経由などでも送ることができるそうです。 EPUB以外のフォーマットにも対応しています。
https://www.amazon.co.jp/gp/help/customer/display.html?nodeId=G5WYD9SAF7PGXRNA
今年買ってよかったものの一つ
上の Kindle Paperwhite(第12世代)。
- 軽い
- 目が疲れない
- e-ink によるインクっぽさ(?)が素敵
ジムで筋トレしたあと、ミスドでこれを使って本を読むのが週末のルーティーンになっています。なおこれで技術書はほとんど読んでないので、技術書向きかというジャッジは私には(いまのところ)できません。
【Rails】paranoia gemの論理削除における、関連オブジェクト削除の流れを追ってみた
論理削除を簡単に実装してくれる、paranoiaというgemがあります。
- paranoiaを使って、あるモデルのオブジェクトを論理削除できるようにしたとき
親モデル has_many :子モデル, dependent: :destroyのとき
上記の状況の際、親の削除に紐づく子の削除が物理/論理のどちらになるかは、以下のとおりです。
この動きはREADMEでも解説されていますが、実際に内部でどのように実装されているのかをソースコードを追って確認してみた、というのが今回の記事になります。
やってみる
Postモデルを作成。
paranoiaを使って、Postモデルのオブジェクトを論理削除できるようにしてみます。gemのREADMEに従って、Gemfileにparanoiaを追加してbundle installしてから、以下を行います。
- postsテーブルに
deleted_atカラムを追加するマイグレーションファイルを追加- このカラムに削除日が入っていれば削除されているものとして扱う
- Postモデルに
acts_as_paranoidを追加
class AddDeletedAtToPosts < ActiveRecord::Migration[8.0]
  def change
    add_column :posts, :deleted_at, :datetime
    add_index :posts, :deleted_at
  end
end
class Post < ApplicationRecord
  acts_as_paranoid # 追加
end
これで論理削除ができるようになります。
post = Post.create(...)で適当にPostを作成- この段階で
Post.allすると、先ほどのPostを取得できる
- この段階で
post.destroyする- この段階で
Post.allすると、先ほどのPostを取得できない Post.with_deletedというスコープを使うと、先ほどのPostを取得できる
- この段階で
post.destroy実行後のSQLを見ると、実際に行っているのはdeleted_atカラムに時刻を入れて更新していることであるのがわかります。
paranoia-test(dev)> post = Post.create(title: 'テスト')
  TRANSACTION (0.1ms)  BEGIN immediate TRANSACTION /*application='ParanoiaTest'*/
  Post Create (2.6ms)  INSERT INTO "posts" ("title", "created_at", "updated_at", "deleted_at") VALUES ('テスト', '2025-03-02 05:35:08.350535', '2025-03-02 05:35:08.350535', NULL) RETURNING "id" /*application='ParanoiaTest'*/
  TRANSACTION (3.0ms)  COMMIT TRANSACTION /*application='ParanoiaTest'*/
=>
#<Post:0x00007f7aad9923c8
...

paranoia-test(dev)> Post.all
  Post Load (0.1ms)  SELECT "posts".* FROM "posts" WHERE "posts"."deleted_at" IS NULL /* loading for pp */ LIMIT 11 /*application='ParanoiaTest'*/
=>
[#<Post:0x00007f7aae22e4c8
  id: 1,
  title: "テスト",
  created_at: "2025-03-02 05:35:08.350535000 +0000",
  updated_at: "2025-03-02 05:35:08.350535000 +0000",
  deleted_at: nil>]

paranoia-test(dev)> post.destroy
  TRANSACTION (0.1ms)  BEGIN immediate TRANSACTION /*application='ParanoiaTest'*/
  Comment Load (0.2ms)  SELECT "comments".* FROM "comments" WHERE "comments"."post_id" = 1 /*application='ParanoiaTest'*/
  Post Update (0.2ms)  UPDATE "posts" SET "deleted_at" = '2025-03-02 05:35:17.146309', "updated_at" = '2025-03-02 05:35:17.146316' WHERE "posts"."id" = 1 /*application='ParanoiaTest'*/
  TRANSACTION (0.2ms)  COMMIT TRANSACTION /*application='ParanoiaTest'*/
=>
#<Post:0x00007f7aad9923c8
 id: 1,
 title: "テスト",
 created_at: "2025-03-02 05:35:08.350535000 +0000",
 updated_at: "2025-03-02 05:35:17.146316000 +0000",
 deleted_at: "2025-03-02 05:35:17.146309000 +0000">

paranoia-test(dev)> Post.all
  Post Load (0.1ms)  SELECT "posts".* FROM "posts" WHERE "posts"."deleted_at" IS NULL /* loading for pp */ LIMIT 11 /*application='ParanoiaTest'*/
=> []

paranoia-test(dev)> Post.with_deleted
  Post Load (0.1ms)  SELECT "posts".* FROM "posts" /* loading for pp */ LIMIT 11 /*application='ParanoiaTest'*/
=>
[#<Post:0x00007f7aae12f8d8
  id: 1,
  title: "テスト",
  created_at: "2025-03-02 05:35:08.350535000 +0000",
  updated_at: "2025-03-02 05:35:17.146316000 +0000",
  deleted_at: "2025-03-02 05:35:17.146309000 +0000">]
関連オブジェクトの削除について
ここでCommentモデルを追加して、Postがhas_many :comments, dependent: :destroyである状態を考えます。
親のPostオブジェクトが、紐づく子のCommentオブジェクトを持っているとき、親を論理削除したときの子の削除の動きは以下のようになっています。
- Commentモデルで
acts_as_paranoidによる論理削除の設定をしていないとき- 子のCommentオブジェクトは物理削除される(DBから消える)
- Commentモデルで
acts_as_paranoidによる論理削除の設定をしているとき- 子のCommentオブジェクトは論理削除される(
deleted_atが更新されて、DBには残る)
- 子のCommentオブジェクトは論理削除される(
1.の状況で親のPostオブジェクトをdestroy(CommentはSQLでDELETEされている)
paranoia-test(dev)> post.destroy
  TRANSACTION (0.1ms)  BEGIN immediate TRANSACTION /*application='ParanoiaTest'*/
  Comment Load (0.1ms)  SELECT "comments".* FROM "comments" WHERE "comments"."post_id" = 1 /*application='ParanoiaTest'*/
  Comment Destroy (0.1ms)  DELETE FROM "comments" WHERE "comments"."id" = 1 /*application='ParanoiaTest'*/
  Post Update (0.1ms)  UPDATE "posts" SET "deleted_at" = '2025-03-02 05:07:22.781654', "updated_at" = '2025-03-02 05:07:22.781670' WHERE "posts"."id" = 1 /*application='ParanoiaTest'*/
  TRANSACTION (3.2ms)  COMMIT TRANSACTION /*application='ParanoiaTest'*/
=>
#<Post:0x00007f54f06b4c60
 id: 1,
 title: "テスト",
 created_at: "2025-03-02 04:59:59.611098000 +0000",
 updated_at: "2025-03-02 05:07:22.781670000 +0000",
 deleted_at: "2025-03-02 05:07:22.781654000 +0000">
2.の状況で親のPostオブジェクトをdestroy(CommentはSQLでUPDATEされている)
paranoia-test(dev)> post.destroy
  TRANSACTION (0.3ms)  BEGIN immediate TRANSACTION /*application='ParanoiaTest'*/
  Comment Load (0.7ms)  SELECT "comments".* FROM "comments" WHERE "comments"."deleted_at" IS NULL AND "comments"."post_id" = 2 /*application='ParanoiaTest'*/
  Comment Update (0.1ms)  UPDATE "comments" SET "deleted_at" = '2025-03-02 05:13:16.316338', "updated_at" = '2025-03-02 05:13:16.316397' WHERE "comments"."id" = 2 /*application='ParanoiaTest'*/
  Post Update (0.0ms)  UPDATE "posts" SET "deleted_at" = '2025-03-02 05:13:16.322941', "updated_at" = '2025-03-02 05:13:16.322947' WHERE "posts"."id" = 2 /*application='ParanoiaTest'*/
  TRANSACTION (0.1ms)  COMMIT TRANSACTION /*application='ParanoiaTest'*/
=>
#<Post:0x00007f1f6e37a2a0
 id: 2,
 title: "aa",
 created_at: "2025-03-02 05:09:28.200792000 +0000",
 updated_at: "2025-03-02 05:13:16.322947000 +0000",
 deleted_at: "2025-03-02 05:13:16.322941000 +0000">
このことはREADMEのこの部分でも解説されています。
なぜこんな動きになるのか
paranoiaのdestroyメソッドはActiveRecordのdestroyメソッドをオーバライドしているacts_as_paranoidをモデルで呼ぶと、1の設定が有効になるdependent: :destroyは「親が削除されたときに、子に対してdestroyメソッドを呼ぶ」ための設定- 親が削除されたとき、子の
destroyの動きが論理 / 物理削除のどちらになるかは、子がacts_as_parainoidを呼んでいるかどうかで決まる
1については、gemのソースコードの以下の部分でわかります。
module Paranoia
  # 中略

  def paranoia_destroy
    with_transaction_returning_status do
      result = run_callbacks(:destroy) do
        @_disable_counter_cache = paranoia_destroyed?
        result = paranoia_delete
        next result unless result && ActiveRecord::VERSION::STRING >= '4.2'
        each_counter_cached_associations do |association|
          foreign_key = association.reflection.foreign_key.to_sym
          next if destroyed_by_association && destroyed_by_association.foreign_key.to_sym == foreign_key
          next unless send(association.reflection.name)
          association.decrement_counters
        end
        @_trigger_destroy_callback = true
        @_disable_counter_cache = false
        result
      end
      raise ActiveRecord::Rollback, "Not destroyed" unless paranoia_destroyed?
      result
    end || false
  end
  alias_method :destroy, :paranoia_destroy
カウンタキャッシュを取り扱うためにごにょごにょやってますが(ここはふわっとしか読んでいません😓)、alias_methodでモデルオブジェクトにdestroyが呼ばれたときに、このparanoia_destroyが実行されるようになっています。
※ ちなみに、実際にdeleted_atの更新を行うのは、このメソッド内部で呼ばれているparanoia_deleteになっています。
2については、acts_as_paranoidメソッドの定義部分でわかります。このメソッドを実行するとParanoiaモジュールをモデルクラスにincludeする(他にも1でされているようなエイリアス設定などを行う)ことで、1で定義されたメソッドがdestroyで呼ばれるようになるわけです。
ActiveSupport.on_load(:active_record) do
  class ActiveRecord::Base
    def self.acts_as_paranoid(options={})
      # 中略

      include Paranoia
3についてはRailsガイドで解説されています。子も含めて論理削除したい場合は、子側でもacts_as_paranoidを呼ぶのを忘れないようにする必要がある、ということですね。
要は、親も子も呼んでいるのはdestroyメソッドですが、挙動が異なるのは「paranoiaが適用されているモデルのdestroyメソッドだけが、Paranoiaモジュールの読み込みによってオーバライドされていたから」という点がポイントだったわけです。
注意: paranoiaは公式からも非推奨と言われている
ここまでparanoiaのことを見てきましたが、公式のREADMEに下のようにあるように、このgemは新規のプロジェクトには非推奨とされています。
paranoia has some surprising behaviour (like overriding ActiveRecord's delete and destroy) and is not recommended for new projects. See discard's README for more details.
まさにここまで見てきたとおり、destroyなどActiveRecordのメソッドをオーバーライドしていることで予期しない挙動を招く可能性があるという注意喚起ですね。またここで紹介されているdiscardというgemでは、discardという独自メソッドで論理削除を行うようになっており(既存メソッドはオーバーライドしない)、これが大きな違いです。
こちらのgemの中身も読んでみましたが、paranoiaよりもシンプルな実装で、自分のような初学者でも全体を読み通すのがそこまで難しくありません。gemの実装を読む練習としても良いサンプルだと思いました。機会があれば、別の記事で取り上げたいと思っています。
(そもそも論理削除自体がアンチパターンである、という議論もあるということも認識はしていますが、ここについて語るための知見はまだありません😓)
おまけ
記事を書きながら聴いていた曲は、BLACK SABBATHの『Paranoid』でした。かっこいい~。
【Rails】ActiveStorageで、既存のオブジェクトに紐づいたファイルを他のオブジェクトに流用して紐づける方法
まとめ
UserモデルとAuthorモデルがある- 既存のユーザー(
user)にアタッチしてあるファイルを、そのまま流用して別の「著者」(author)にアタッチしたい
上記のことが、以下のコードで可能という記事です。
author.authors_image.attach(user.users_image.blob)
やってみる
rails newして、User/Authorモデルを作る- ActiveStorageを導入して、
has_one_attachedでモデルとファイルを紐づける設定をする - ビューで画像を表示できるようにしておく
- 下のサンプルコードは
Userのビューのものだけだが、Authorのビューでも同じことをしておく
- 下のサンプルコードは
class User < ApplicationRecord
  has_one_attached :users_image
end

class Author < ApplicationRecord
  has_one_attached :authors_image
end
<div id="<%= dom_id user %>">
  <p>
    <strong>Name:</strong>
    <%= user.name %>
  </p>

  <p>
    <strong>image:</strong>
    <% if user.users_image.present? %>
      <%= image_tag user.users_image %>
    <% end %>
  </p>

</div>
適当にユーザーを作って、画像をアタッチして保存。
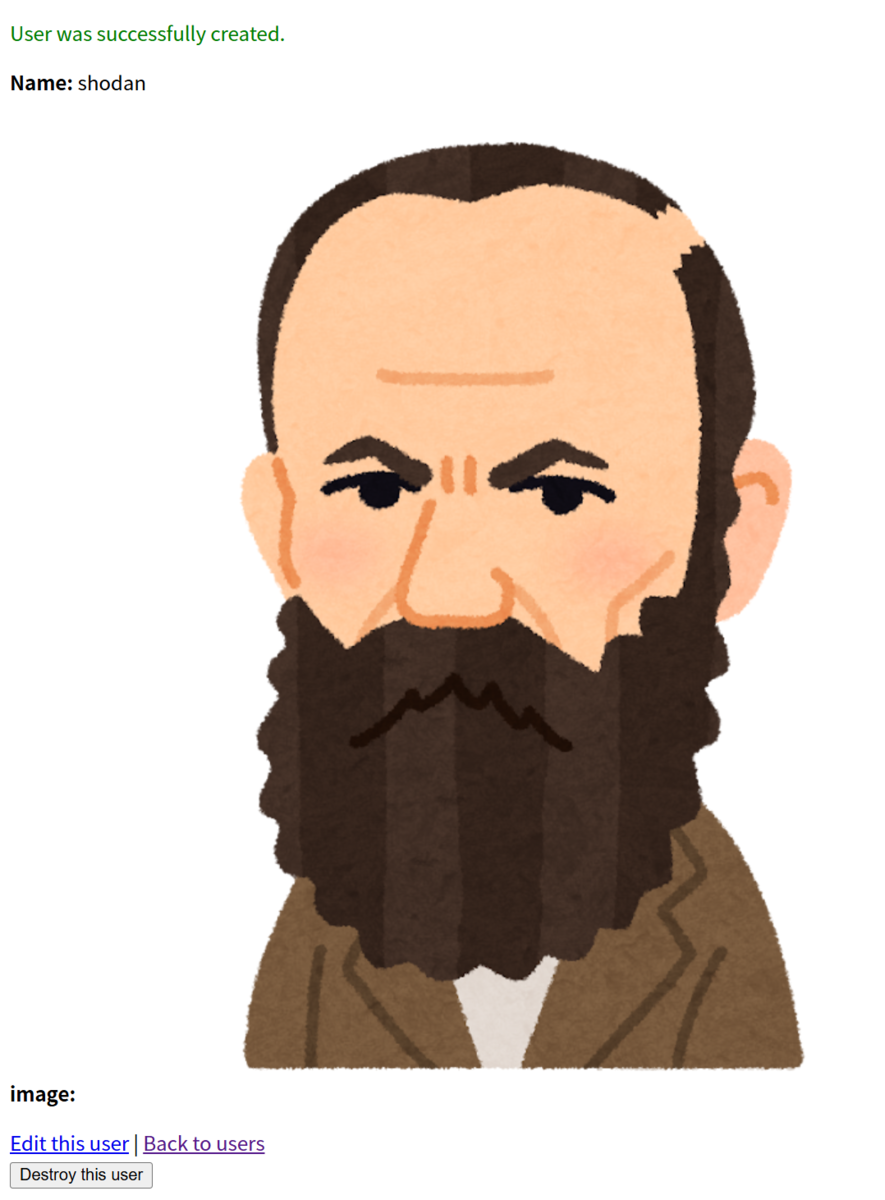
次に、適当に著者を作成(この時点では画像は持たせない)。
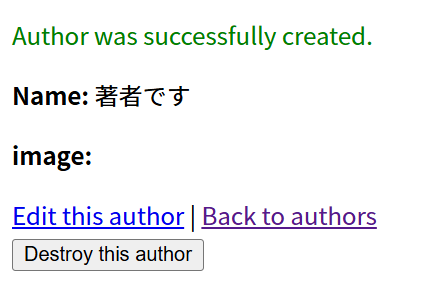
Railsコンソールを開いて、ユーザーと著者を取得し、冒頭のコマンドを実行。
$ user = User.first
$ author = Author.first
$ author.authors_image.attach(user.users_image.blob)
attach-test-app(dev)> author.authors_image.attach(user.users_image.blob)
  ActiveStorage::Attachment Load (0.1ms)  SELECT "active_storage_attachments".* FROM "active_storage_attachments" WHERE "active_storage_attachments"."record_id" = 2 AND "active_storage_attachments"."record_type" = 'User' AND "active_storage_attachments"."name" = 'users_image' LIMIT 1 /*application='AttachTestApp'*/
  ActiveStorage::Blob Load (0.1ms)  SELECT "active_storage_blobs".* FROM "active_storage_blobs" WHERE "active_storage_blobs"."id" = 2 LIMIT 1 /*application='AttachTestApp'*/
  TRANSACTION (0.5ms)  BEGIN immediate TRANSACTION /*application='AttachTestApp'*/
  ActiveStorage::Blob Load (4.4ms)  SELECT "active_storage_blobs".* FROM "active_storage_blobs" INNER JOIN "active_storage_attachments" ON "active_storage_blobs"."id" = "active_storage_attachments"."blob_id" WHERE "active_storage_attachments"."record_id" = 3 AND "active_storage_attachments"."record_type" = 'Author' AND "active_storage_attachments"."name" = 'authors_image' LIMIT 1 /*application='AttachTestApp'*/
  ActiveStorage::Attachment Load (0.2ms)  SELECT "active_storage_attachments".* FROM "active_storage_attachments" WHERE "active_storage_attachments"."record_id" = 3 AND "active_storage_attachments"."record_type" = 'Author' AND "active_storage_attachments"."name" = 'authors_image' LIMIT 1 /*application='AttachTestApp'*/
  ActiveStorage::Attachment Create (0.2ms)  INSERT INTO "active_storage_attachments" ("name", "record_type", "record_id", "blob_id", "created_at") VALUES ('authors_image', 'Author', 3, 2, '2025-02-23 02:56:27.784094') RETURNING "id" /*application='AttachTestApp'*/
  Author Update (0.1ms)  UPDATE "authors" SET "updated_at" = '2025-02-23 02:56:27.788402' WHERE "authors"."id" = 3 /*application='AttachTestApp'*/
  TRANSACTION (0.1ms)  COMMIT TRANSACTION /*application='AttachTestApp'*/
=>
#<ActiveStorage::Attached::One:0x00007f509baccea0
 @name="authors_image",
 @record=
  #<Author:0x00007f509b672620
   id: 3,
   name: "著者です",
   created_at: "2025-02-23 02:52:29.138843000 +0000",
   updated_at: "2025-02-23 02:56:27.788402000 +0000">>
著者のページを更新すると、ビュー上のコードimage_tag(author.authors_image)によってユーザーと同じ画像が表示されます。
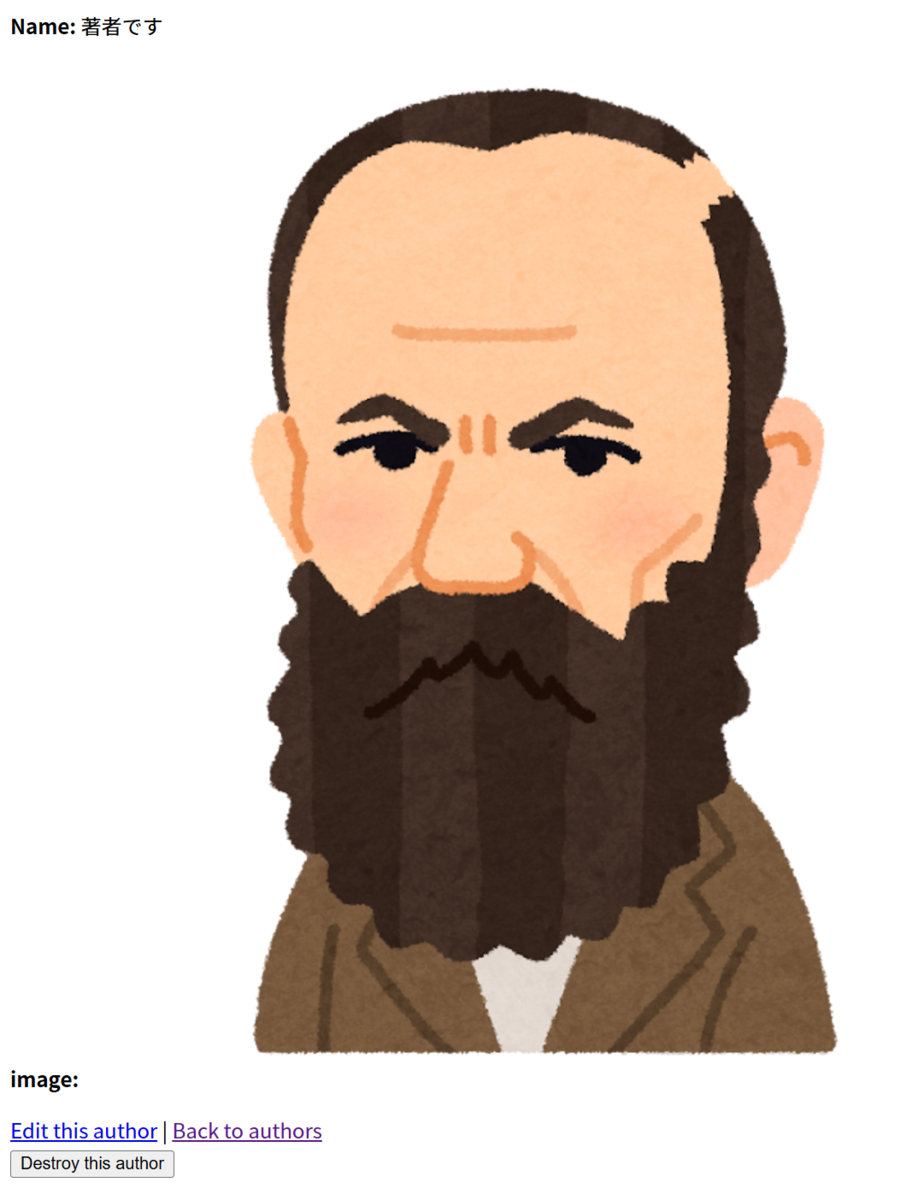
ユーザー / 著者に紐づく画像が同じものであることは、Railsコンソールからも確かめられます。
attach-test-app(dev)> user.users_image.blob == author.authors_image.blob
=> true
なぜできるのか
ActiveStorageでオブジェクトとファイルを紐づける際、オブジェクト(今回であればユーザーや著者)とファイル(1)は下のように中間テーブル(2)を通して結ばれます。
- ファイルに関するデータのためのテーブル:
active_storage_blobs - 中間テーブル:
active_storage_attachments- 1のblobsとオブジェクトを接続する役割
冒頭のコードは、「著者オブジェクトの画像として、ユーザーオブジェクトに紐づく画像のファイルデータ(blob)をアタッチしてね」という意味だったわけですね(attach(user.users_image)だとうまくいきません)。
author.authors_image.attach(user.users_image.blob)
※更に調べてみると、user.users_imageで取得できるオブジェクトのクラスはActiveStorage::AttachmentではなくActiveStorage::Attached::Oneです。このオブジェクトはアタッチされたファイルのラッパーのようなクラスのようで、ファイルがアタッチされているかを確認するattached?メソッドもここに定義されていました。
実行結果のSQLでも分かる通り、このときに作られているのは中間テーブルのレコードだけです(すでにストレージにある画像を著書に新たに紐づけるためのレコード)。
実際、実行後の中間テーブルのレコードの数は2個ですが、ファイルデータのためのテーブルのそれは1個のみ(画像自体は1枚しかアップロードしていない)であることが確認できます。
attach-test-app(dev)> ActiveStorage::Attachment.count
  ActiveStorage::Attachment Count (0.7ms)  SELECT COUNT(*) FROM "active_storage_attachments" /*application='AttachTestApp'*/
=> 2
attach-test-app(dev)> ActiveStorage::Blob.count
  ActiveStorage::Blob Count (0.9ms)  SELECT COUNT(*) FROM "active_storage_blobs" /*application='AttachTestApp'*/
=> 1
同じ画像を使うために再度ファイルをアップロードする必要がないのはよさそうですね。ただ、同じ画像を使い回すこと自体には「どちらか一方で削除・更新が起こったら?」という問題が付いてきそうなので、注意が必要かなとも思いました。
なんでこんな記事を書いたのか
実際にこういうことができないかを考える機会があり、さっと調べたところ日本語の記事がパッと出てこなかったので書いておこうと思ったためです。
Railsのリポジトリでは英語でこれについてのやりとりがなされていましたので、大変参考にさせていただきました。またActiveStorageの構造の話は『パーフェクトRuby on Rails』にもしっかり書かれており、大変助かりました。
以上です。
asdf 導入メモ(Rubyのビルドや.ruby-versionを読み込むなど)
最近購入したWindowsマシンでも開発ができるように、WSL2でUbuntuを入れてその中で環境構築をやっています。
この記事は、以前から興味のあったバージョン管理ツールasdf(複数の言語のバージョンをまとめて管理できるツール)をその過程で導入したときのメモです。
asdf本体の導入から各言語のインストールまで
公式Docで丁寧に説明されているので、この手順に従えばOK。
Rubyを入れようとしたらビルドできない
Rubyを入れようとするとエラー。ビルドに失敗したとのこと。依存パッケージが足りていなさそう。
$ asdf install ruby latest
*** Following extensions are not compiled:
fiddle:
        Could not be configured. It will not be installed.
        /tmp/ruby-build.20241231120425.28270.fgb3u0/ruby-3.3.4/ext/fiddle/extconf.rb:78: missing libffi. Please install libffi or use --with-libffi-source-dir with libffi source location.
        Check /tmp/ruby-build.20241231120425.28270.fgb3u0/ruby-3.3.4/ext/fiddle/mkmf.log for more details.
psych:
        Could not be configured. It will not be installed.
        Check /tmp/ruby-build.20241231120425.28270.fgb3u0/ruby-3.3.4/ext/psych/mkmf.log for more details.

BUILD FAILED (Ubuntu 24.04 on x86_64 using ruby-build 20241225.2)
調べてみると、asdfでRubyを入れるときは、内部ではasdf-rubyというプラグインがruby-buildを使ってRubyをビルドしているとのこと(確かにインストール中の表示はrbenvを使ったインストールと同じだった気が)。
Under the hood, asdf-ruby uses ruby-build to build and install Ruby, check its README for more information about build options and the troubleshooting wiki section for any issues encountered during installation of ruby versions.
ということでruby-buildのドキュメントを見に行く。Ubuntuでビルドする際の依存パッケージの説明があったので、導入。
$ apt-get install autoconf patch build-essential rustc libssl-dev libyaml-dev libreadline6-dev zlib1g-dev libgmp-dev libncurses5-dev libffi-dev libgdbm6 libgdbm-dev libdb-dev uuid-dev
再度$ asdf install ruby latestを実行すると、無事Rubyをインストールすることに成功しました。他の言語を入れるときも、事前に該当するasdfのプラグインのリポジトリを見ておいたほうがよさそうですね。
asdfでも.ruby-versionsを読み込みたい
asdfでは、.tool-versionsというファイルでバージョンを管理します。
ruby 2.5.3
nodejs 10.15.0
一方、RailsプロジェクトのRubyだったら.ruby-version(rbenv)で管理されていることが多そうですし、Node.jsだったら.nvmrc(nvm)など、それぞれのプロジェクトで採用されたバージョン管理ツールのファイルが既にあるかもしれません。
その場合、自分のためだけに.tool-versionsをコミットするのはどうなんだろうとか、相談の結果コミットしないのだとしたら自分のマシンのグローバルのバージョンを都度変更して対応するのか、とか色々と考えてしまい、私はなかなかasdfを試せていなかった感じでした。
ですが、asdfはそのあたりも解決してくれることを今回の導入で知りました。
ホームディレクトリに.asdfrcという設定ファイルを作って、以下の設定を追加するだけです。これで、.ruby-versionのあるプロジェクトでは、その内容を読み取ってRubyのバージョンを選択してくれるようになります。とても便利。
legacy_version_file = yes
asdf supports the migration from existing version files from other version managers. Eg: .ruby-version for the case of rbenv. This is supported on a per-plugin basis.
asdf-nodejs supports this via both .nvmrc and .node-version files. To enable this, add the following to your asdf configuration file $HOME/.asdfrc:
上の説明では.ruby-version、.nvmrc 、.node-versionには確実に対応しているみたいでしたが、互換性を一覧化したリストは公式には無さそう?内部の実装を読めばわかるかもなので、また見てみようかなと思います。
Ruby LSPで使用するバージョン管理ツールをasdfに指定する
WindowsのVSCodeの設定は、Macでの設定(rbenv使用)と同期させており、Ruby LSPがそのままだとうまく動かないので設定を変更。
  "rubyLsp.rubyVersionManager": {
    "identifier": "asdf"
  },
こうすると無事に動くのですが、このままだと今度はMac側のRuby LSPが動かなくなるので、この項目だけVSCodeの設定同期から外すように変更。
"settingsSync.ignoredSettings": ["rubyLsp.rubyVersionManager"]
この設定ができるのはありがたいですね。下の記事を参考にさせていただきました。
以上です。
2024年のふりかえり
2024年の自分のやったことをふりかえる記事です。
2023年末に言っていたこと
去年の自分のふりかえりで言っていたこと。
2024年が私にとってプログラマとしてのキャリアをスタートさせた一年になるよう、とにかく頑張っていきたいと思います。
また、地域Rubyや各種イベントにも積極的に参加していきたいと思っています。
2024年にできたこと
- 2024年が私にとってプログラマとしてのキャリアをスタートさせた一年になった。
- 正確に言うと働くのは2025年1月から。受託の会社さん(フルリモート)で開発の仕事をさせて頂く予定です。
- 最終的なお返事をしたのが11月だったので、2024年がキャリア転機の年ということにはなりそうです。
- 地域Rubyや各種イベントにも参加した。
- 沖縄のRubyKaigi 2024や関西圏の地域Rubyに参加しました。また福岡の地域勉強会では初めての発表も経験しました。
- 資格を取った。
就活
9月頃に、生活環境にある変化が起きました。それだけが原因というわけではないのですが、それが最後の一押しになり、フィヨルドブートキャンプでの学習を中断して就職活動を本格的に始めることになりました。
ありがたいことに複数社さんから内定をいただき、11月の始めに就活を終えました。今は、とりあえず着地できてよかったという思いだけがあります。
印象深かったこととして、自分のOSS活動に興味を持っていただけた複数の会社さんとのやりとりがあります。そのどれもが、私としては「結果に関わらず、お会いできてよかったな」と思えるものでした。
OSS活動と言っても、パッチの送付ではなくドキュメントの修正(とあるChrome拡張機能や、Railsガイドに送った複数のPRなど)ですが、それが印象に残ったと言っていただけるのは嬉しかったです。これは、私自身もそのようなことが自然になされているようなコミュニティにいれたらいいなあ、という思いがあったからかなと思います。
このあたりは、私が勉強していたフィヨルドブートキャンプというコミュニティがそうだから、というのが大きそうですね。RubyKaigiなどに参加したことも繋がっていそうです。
なお、仕事ではTSを触る機会が多くなりそうで、11月以降は基本情報と並行して勉強したりしていました。来年のRubyKaigi松山はちょっと難しいかもですが、できる範囲で地域Rubyや勉強会には参加できたらと思っています。
2025年にやりたいこと
やりたいことというか、こうありたいという感じです。
とにかくもう、これだけです。変にやる気を出してあれこれ足すと(資格を取るとか、業務外でも〇〇するとか)、自分にプレッシャーを掛けそうなので。
起きて、朝日を浴びて、身支度を整えて、PCの前に座って、コードを書いたり、詰まったり、質問したり、必要なことをインプットしたりするのを繰り返して、気づいたら2026年もなんとかプログラマとして迎えられた、そんな感じだったらいいなと思っています。
昔からプログラマをやっている人からするとごく当たり前なこのことが、初めて経験する私にとってはおそらく大変かもしれないと想像します。でも、自分を追い込みすぎず、適度な大きさに分解した眼の前の問題に向き合って、一つの小さな過程を乗り越えられたら、自分を褒めてまた次に行く。そんなサイクルを繰り返していけたら120点ですね。
その他の小さなこと
就活が終わったので、自分へのご褒美としてゲーミングPCを買いました。今更ながら初めてSteamでゲームをしています(といってもそんなにたくさんやれてないんですが)。学習していたここ1年半ほどはゲームから遠ざかっていたので、最新のものから手を付けられていなかった過去作まで、色々やっていきたいです。
あと、就職後も筋トレをなんとか継続したいです。キャリアブレイク中は平日に週3〜5ペースで学習の合間に筋トレに行けたのですが、来年はどうしようという。エニタイムフィットネスでやっていたのですが、今と同じペースでは通えなくなるので一旦解約しました。
はじめのうちは仕事に慣れるのが精一杯で筋トレとかじゃなくなると思うので、それでも気が向いたときは近所の市営ジムを都度利用して、仕事に慣れたらまたエニタイムという作戦を考えてはいます。夜は混んでいると思うので早朝とか……。
おわりに
フィヨルドブートキャンプでは休会ステータスになっていると思います。そこでお世話になった皆様には、ここで感謝を伝えさせてください。本当に、ありがとうございました。イベントなどでお会いした際は、またご挨拶させてください。
それでは、良いお年をお迎えください。
基本情報技術者試験(2024年10月新シラバス)に1ヶ月半で合格見込みとしたときにやったこと
数日前に基本情報技術者試験を受験し、合格見込みとなりました。2024年11月半ばに、年内に取得する必要が発生したので、1ヶ月半ほど準備をしていた感じでした。
- 科目A: 835点
- 科目B: 725点
合格基準は両科目共に600点以上の取得。
この記事は勉強法などについてのメモ書きです。
※本記事の情報は2024年12月29日現在のものなので、参考にされる方は注意してください。
大まかな勉強法
「基本情報 勉強法」のように検索すると、参考になる合格体験記がたくさん出てきます。ただ、取るべき勉強の流れとしてシェアなされていることはどれも大まかに同じ印象です。そしてそれはこの記事においても同じです。
- シラバスをカバーする参考書を1冊入手し、まずは1周読んでみる。
- 過去問を周回し、インプットした知識を定着させる。
テキスト
下のテキストを使いました。なお私が勉強を始めたときは、新シラバスに対応している下の令和7年度版が出版されておらず、令和6年度版を使っていました。
この記事を書いている時点では、有名どころの参考書が新シラバスに対応しているようなので、古いものを買わないように気をつけたほうがよさそうです。
問題演習
「過去問道場」さんのお世話になりました。このサービスを紹介していない合格体験記はないといっていいくらい、定番&&素晴らしいサービスです(試験までに直近10年分の過去問を約2周)。
直近10年分の問題を1周した後、自分が苦手だと思う単元やテーマについてはテキストを読み返し、その後2週目に取り組んだ感じです。
また、この記事の表題にもあるように2024年10月からシラバスが変更されています。このシラバスに対応したサンプル問題は、現時点では公式から配布されていないため、新シラバスで追加された用語を問う問題の演習をするために、私は下の問題集を使用しました(試験までに2周)。
新シラバス以外の問題については「過去問道場」と被る部分もありますが、新シラバス用の問題+過去問題から構成した独自の「想定模試」という感じの作りになっているので、学習期間の中〜終盤の腕試しとして良かった感じです。また後述の科目Bについてもいくつかのオリジナル問題を収録してくれているので、こちらもありがたかったです。
科目Bについて
科目Bでは、擬似言語で書かれたソースコードを読んで、特定の引数を渡した際の実行結果を答えたり、コードの穴開き部分を埋めたりするような問題に取り組むことになります。
調べると「日頃から自分でコードを書く人なら簡単」という意見もあったのですが、以下の理由から個人的には「疑似言語問題に慣れるため」の演習はしっかりとしておいたほうがいいと考えました。
- ちょっと複雑な条件分岐を伴う2重ループとかの中で、変数の再代入・破壊的変更などが割とさらっと行われたりする。
- このような「ちょっと頭の中だけでは読みづらいかも」と思うコードが与えられて、「この関数にこの引数を渡して実行したとき、ループ内のこの行は何回実行される?」のような問題を解いたりする必要がある。
(※いずれも公開サンプルや参考書の問題をみた個人の印象です)
試験ではメモ用紙が配布されるので、実行時の変数の状態をメモしながらコードを追っていく感じになります。
学習の中で、条件分岐の混じった二重ループを追ったりしていたときは「これ、実際の作業だったらプリントデバッグなりデバッガなりでやってるよな〜」と思っていましたが、求められているものが違うのでこればっかりは仕方ないですね(私のコードリーディング力が無いことももちろんあります)。
ということで演習は必要だと考えるのですが、科目Bがこのスタイルになったのが2023年とのことで、公式が公開しているサンプル問題の量には限りがあります。なので、私は下の問題集で補完しました(試験までに2周)。
こちらの応用問題の後半は結構歯ごたえがありますが、基本的なアルゴリズムや最低限さらっておくべき数学知識の解説もしてくれているので、いい勉強になりました。
また、科目Bは時間制限が結構きついです(100分20問、うちコードを読む問題は16問、残りはセキュリティに関する長文問題)。ややこしい2重ループや再帰の問題のすべてを一行一行トレースしていると間に合わないので、細かく読むところとそうでないところを見極める必要があります。そのあたりのトレーニングのために、「公式の公開サンプル問題」「パーフェクトラーニング」については試験と同様に時間を図って取り組みました。
本番について
科目A90分、休憩10分、科目B100分というスケジュールなので、集中力の維持も重要なテーマだと思います。休憩時間が短いので、事前にコンビニで水やブドウ糖を用意しておきました。
本番では緊張もあったのか、科目Aの後半で結構クタクタになったので、学習終盤のどこかで(科目ごとではなく)試験全体のスケジュールで模試をやって、感覚を慣らしてもよかったかなと今更ながら思っています。
また、問題は頭から順番に解く必要はなく、飛ばした問題に後で戻って来ることも可能なので、以下のような問題は基本的に後回しにすることを事前に決めていました。
- 科目Aの計算問題
- ややこしめの論理演算や確率、その他あらゆる計算問題など。パッと見で2分くらいでは解けないと思ったら飛ばすという作戦を事前に決めていました。
- 科目Bのややこしそうな問題
- この「ややこしそう」というのも初見の印象で判断。1分くらい眺めて「パッとは解けなさそう、ややこしそうかも」と思ったら飛ばすことに決めていました。
- 後半のセキュリティ問題から解く作戦もあるみたいですが、私は1問目から順に解くことは決めていました(なんとなくそれがしっくり来たから)。
この「ややこしそうだから飛ばす」というのは、ぶっつけ本番ではかなり勇気がいりそうだと思ったので、上述の模試的な演習でも同様に練習していました。
その他のこと
勉強期間など
私は次の職までのキャリアブレイク中だったので、1ヶ月半ほど勉強する時間を取れましたが、働きながらだとまた違う期間になっていたかもです。また、「IT関連の知識がまったくない」状態からだと最初のインプットに結構時間がかかると思うので、1ヶ月台はちょっと難しいかも?と思いました(頑張り次第だとは思いますが)。
逆に、私のように何らかの手段で「Webアプリケーション開発についてある程度学習はしている」という方であれば、試験範囲の3割くらいはその知識でカバー出来ているかなという感じです(※個人の印象)。
例えば調べていると「オブジェクト指向の問題が難しい、なぜそうなるかわからない」という声を見たりするのですが、このあたりの過去問をやってみると科目A・B問わず簡単に解けました。
フィヨルドブートキャンプでチーム開発まで行っている人なら、十分な下地がありそうな気がするので、興味があるなら過去問やシラバスをサラッと見てみるのもいいかもしれないなと思います。
勉強の効果
目に見える範囲では、各種SNSやGoogleのフィードに流れてくる(自分の関心や取り組んでいる対象と距離があるものを含めた)技術記事をなんとなくチラ見したときの解像度が、ちょっとだけ上がったような気がしています。ふんわりした話で申し訳ないですが、本当にそんな感じです。おそらく、この世界の基礎の基礎の基礎部分の体力がついた感じなんでしょうね。でも、確実に勉強してよかったと思っています。
もう少し細かい具体例でいうと、最近家のWi-Fiを見直したのですが、そこで出会う各種用語(DHCPとか)や背景に関する知識が増えたので、この作業の解像度もグッと上がりました。
このあたりの効能については、下の記事がとてもよくまとめてくださっていますので、最後にシェアさせていただきます。
とにかく、無事に終わったのでよかったです。応用情報も受けてみたいんですが、来年春は忙しくなりそうなので厳しいかも。
おまけ
電車で1時間くらいかけて神戸まで受けに行ったので、合格後の夜は一人忘年会をしました。
その後は、神戸のジャズ喫茶の中ではおそらく最爆音?かつリスニング専用席もある本格的なジャズ喫茶「Jam Jam」で一杯。
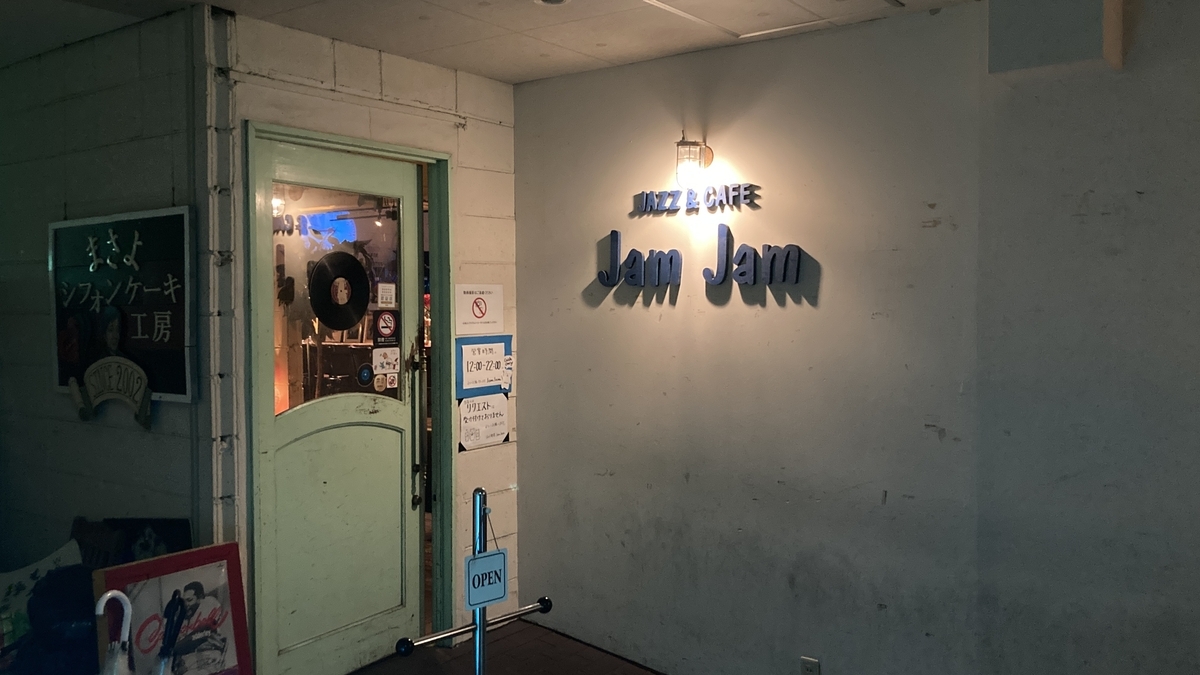
やっぱりレコードは最高です。それでは。
